Neste artigo
- Os quatro lançamentos, só com o que a fonte oficial confirma
- O que os próprios fabricantes estão dizendo nas entrelinhas
- Por que preço por token engana
- A conta que eu faço: custo por tarefa aceita
- Meu roteamento por tipo de tarefa
- Como eu testo um modelo novo sem cair no hype
- O que eu faria se estivesse começando hoje
- Perguntas frequentes
- Qual é o melhor modelo de IA para programar agora?
- Benchmark não serve para nada, então?
- Vale pagar o modo rápido?
Em dez dias saíram quatro modelos que, juntos, cobrem praticamente tudo o que eu uso no trabalho: a Anthropic lançou o Claude Fable 5.2 no dia 9, o Google colocou o Gemini 4 Hydrogen no ar na semana passada e o Gemini 4 Neon nesta quarta (18), e a OpenAI soltou o GPT-6.2 Astra e o GPT-6.2 Sol na terça (17). Cada anúncio veio com a sua tabela de benchmarks e a promessa de ser “o melhor” em alguma coisa.
Se eu fosse trocar de modelo a cada anúncio, passaria a semana migrando prompt em vez de entregar código. Por isso, já faz um tempo que mudei a pergunta. Não pergunto mais “qual é o melhor modelo?”, e sim “qual é o modelo mais barato que resolve esta tarefa de primeira?”.
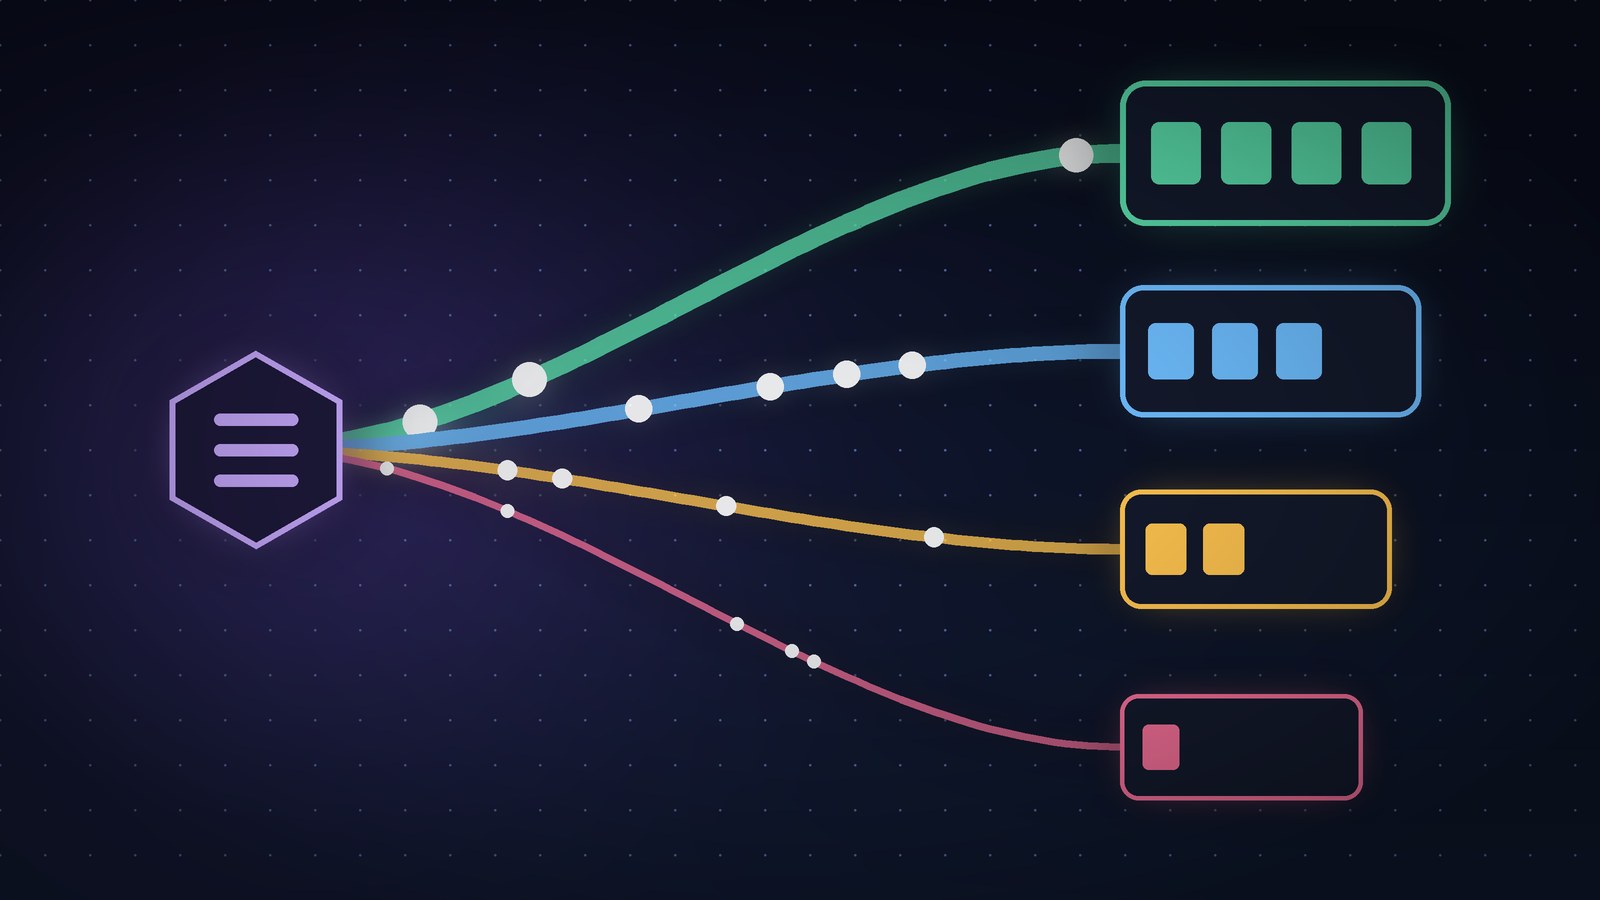
Minha tese: a era do modelo padrão acabou, e o próprio mercado admitiu isso nesta semana. Lendo com calma os anúncios oficiais, os três fornecedores dizem a mesma coisa, cada um do seu jeito: use um modelo caro para pensar, um barato para executar e meça o custo por tarefa, não o preço por token. Neste artigo eu mostro como faço essa escolha no dia a dia, com os preços oficiais na mesa e um exemplo de conta que você pode adaptar.
Os quatro lançamentos, só com o que a fonte oficial confirma
Antes da opinião, os fatos. Todos os preços abaixo são da API, em dólar por milhão de tokens, tirados das páginas oficiais de cada empresa:
- Claude Fable 5.2 (Anthropic, 9/11): US$ 8 de entrada e US$ 40 de saída, abaixo dos US$ 10/50 do Fable 5.1. Leitura de cache sai a US$ 0,20. Existe um modo rápido, até 2,5 vezes mais veloz, a US$ 16/80. (anúncio e documentação)
- Gemini 4 Hydrogen (Google): US$ 1,50 de entrada e US$ 7,50 de saída, com preço fixo em toda a janela de 1 milhão de tokens. Entrada em cache a US$ 0,075. O Google o descreve como o modelo para codar no dia a dia e para agentes. (anúncio e documentação)
- Gemini 4 Neon (Google, 18/11): US$ 3 de entrada e US$ 15 de saída, cache a US$ 0,15 e janela de 1 milhão de tokens. Não está disponível no plano gratuito da API. A própria documentação o coloca entre o Hydrogen e o Carbon. (anúncio e documentação)
- GPT-6.2 Astra e GPT-6.2 Sol (OpenAI, 17/11): o Astra custa US$ 8 de entrada, US$ 0,40 em cache e US$ 40 de saída, 20% menos que o GPT-6 Astra. O Sol mantém o preço do 6.1 Sol: US$ 2 de entrada, US$ 0,10 em cache e US$ 10 de saída. (anúncio e página do Sol na API)
Para completar o quadro da Anthropic, porque é a família que eu mais uso, a tabela de preços oficial lista o Opus 5.5 a US$ 4/20, o Sonnet 5.5 a US$ 2/10 e o Haiku 5.5 a US$ 0,10/0,50 para prompts de até 100 mil tokens.
O que os próprios fabricantes estão dizendo nas entrelinhas
A parte mais interessante dos anúncios não está nos gráficos. Está nas recomendações de uso, que quase ninguém comenta.
A Anthropic diz, com todas as letras, que o Fable 5.2 é para o trabalho técnico mais ambicioso e aberto. Para a maioria das tarefas de código, a recomendação é começar pelo Opus 5.5 e trocar de modelo conforme o escopo: subir para o Fable quando precisar ou descer para o Sonnet 5.5 e o Haiku 5.5. Ela ainda sugere usar o Fable como “Advisor”, consultado por modelos menores quando o problema aperta, ou como “Orchestrator”, que delega as tarefas simples para modelos menores.
O Google vai na mesma linha. A documentação do Hydrogen recomenda mandar os turnos de planejamento para o Carbon e os de execução para o Hydrogen dentro da mesma sessão. O anúncio diz que os times usam os modelos de fronteira para decisões de arquitetura e bugs difíceis, mas precisam de um modelo rápido e disciplinado para escrever código, rodar testes e verificar mudanças.
A OpenAI fala em números. Segundo o anúncio, no FrontierCode 2.0, um benchmark da Cognition que avalia se mudanças em codebases reais seriam aceitas pelos mantenedores, o GPT-6.2 Sol fica a 0,5 ponto do Astra custando cerca de um quinto (os dois no máximo de raciocínio). É benchmark do próprio fornecedor, então eu desconto. Mas o recado é claro: para muita tarefa de código, o modelo “do dia a dia” chega perto do topo por uma fração do preço.
Ou seja, três empresas que competem pelo seu cartão de crédito estão dizendo que você não deveria usar o modelo mais caro delas para tudo. Quando o vendedor recomenda o produto mais barato, vale prestar atenção.
Por que preço por token engana
Olhando só a tabela, a escolha parece óbvia: pega o mais barato. Na prática, não é assim, por três motivos que eu aprendi pagando fatura.
1. Raciocínio é cobrado como saída. O Google deixa isso explícito: no Neon e no Hydrogen, cada token processado é cobrado, inclusive os tokens de raciocínio, ao preço de saída. E os dois vêm com o nível de raciocínio padrão em high. Se você nunca mexeu nesse parâmetro, está pagando raciocínio alto até para renomear uma variável.
2. Modelo que gasta menos tokens pode sair mais barato, mesmo custando mais por token. A OpenAI diz que o GPT-6.2 Astra usou 22% menos tokens de saída que o GPT-6 Astra no GDPval v2. Se um modelo resolve em uma tentativa curta o que outro resolve em três tentativas longas, o preço unitário vira detalhe. Já escrevi sobre esse efeito contraintuitivo em por que respostas mais curtas de IA podem custar mais caro.
3. Contexto longo muda a conta. No GPT-6.2 Sol, acima de 272 mil tokens de entrada, o preço de entrada dobra e o de saída sobe 1,5 vez para a requisição inteira, segundo a página do modelo. Já Hydrogen, Neon e a família Claude 5.x (exceto o Haiku 5.5) cobram o mesmo preço em toda a janela de 1 milhão. Para quem joga o repositório inteiro no contexto, isso pesa mais que a diferença de preço na primeira linha da tabela.
A conta que eu faço: custo por tarefa aceita
A métrica que eu uso não é custo por token nem nota em benchmark. É custo por tarefa aceita: quanto eu gastei, somando as tentativas, até ter uma mudança que passou nos testes e na minha revisão.
Para enxergar a ordem de grandeza, faço uma simulação simples. Os números de consumo abaixo são uma suposição minha, típica de uma tarefa média de agente no meu dia a dia, e não medição de nenhum fornecedor: 200 mil tokens de entrada, sendo 150 mil reaproveitados do cache, e 20 mil tokens de saída (já contando raciocínio). Ignorei o custo de escrita de cache para simplificar.
| Modelo | Entrada nova (50k) | Cache (150k) | Saída (20k) | Total por tentativa |
|---|---|---|---|---|
| Gemini 4 Hydrogen | US$ 0,075 | US$ 0,011 | US$ 0,15 | ~US$ 0,24 |
| GPT-6.2 Sol | US$ 0,10 | US$ 0,015 | US$ 0,20 | ~US$ 0,32 |
| Claude Sonnet 5.5 | US$ 0,10 | US$ 0,015 | US$ 0,20 | ~US$ 0,32 |
| Gemini 4 Neon | US$ 0,15 | US$ 0,023 | US$ 0,30 | ~US$ 0,47 |
| Claude Opus 5.5 | US$ 0,20 | US$ 0,03 | US$ 0,40 | ~US$ 0,63 |
| Claude Fable 5.2 | US$ 0,40 | US$ 0,03 | US$ 0,80 | ~US$ 1,23 |
| GPT-6.2 Astra | US$ 0,40 | US$ 0,06 | US$ 0,80 | ~US$ 1,26 |
Agora vem o pulo do gato: se o modelo de US$ 0,24 precisa de quatro tentativas e mais vinte minutos meus revisando, ele saiu mais caro que o de US$ 1,23 que acertou de primeira. Hora de dev sênior custa muito mais que qualquer linha dessa tabela. Por outro lado, se a tarefa é mecânica e o modelo barato acerta de primeira 9 em cada 10 vezes, usar o topo de linha nela é jogar dinheiro fora, cinco vezes mais por tentativa.
A tabela não diz qual é o melhor modelo. Ela mostra o tamanho da aposta que você faz a cada tentativa. Quem decide é a taxa de acerto no seu código, e só você consegue medir isso.
Meu roteamento por tipo de tarefa
Na prática, eu divido o trabalho em quatro baldes. Os nomes dos modelos mudam a cada mês; os baldes, não.
- Mecânico e repetitivo (renomear, ajustar import, gerar teste a partir de um padrão que já existe, migrar sintaxe): modelo barato e raciocínio baixo. Aqui entram o Hydrogen, o Sol ou o Sonnet. Errou? Custa centavos repetir.
- Feature comum em código que eu conheço (endpoint novo em FastAPI ou Laravel, tela em React, query nova): o modelo “do dia a dia” da casa, com raciocínio médio. Para mim é o Opus 5.5 ou o Sol, conforme a ferramenta em que estou.
- Planejamento, arquitetura e bug cabeludo (race condition, integração com SDK de anúncios que se comporta diferente em produção, decisão que vai durar anos): modelo de topo, raciocínio alto, e eu peço o plano, não o código. Fable 5.2 ou Astra entram aqui, e o volume de tokens é pequeno, porque o resultado é um documento curto.
- Revisão: um modelo diferente do que escreveu. Não porque um seja melhor que o outro, mas porque erros de famílias diferentes se correlacionam menos. É o padrão “verificador” que o próprio Google sugere ao parear Hydrogen com Carbon e Neon.
O padrão que mais me economiza é o planeja caro, executa barato: o modelo de topo escreve um plano com arquivos, passos e critérios de aceite, e o modelo barato executa passo a passo com testes. É exatamente o que a Anthropic chama de “Orchestrator” e o que o Google recomenda com Carbon e Hydrogen. A diferença é que eu faço isso há meses de forma manual, e agora os fornecedores estão transformando em recomendação oficial.
Como eu testo um modelo novo sem cair no hype
Quando sai um modelo, eu não leio o gráfico e migro. Faço três coisas:
- Rodo minha bateria de tarefas reais. Tenho um conjunto pequeno de tarefas de repositórios meus, já resolvidas, com testes que dizem se a solução presta. Rodo o modelo novo nelas e anoto acertos de primeira, tokens e custo. Leva uma tarde e vale mais que qualquer leaderboard. Expliquei esse tipo de avaliação em como avaliar LLMs antes de colocar em produção.
- Testo o nível de raciocínio, não só o modelo. O Google recomenda testar
mediumehighna sua suíte de avaliação para equilibrar velocidade e custo. Concordo: muitas vezes o mesmo modelo emmediumresolve o balde 2 pela metade do custo. - Espero uma semana para trocar o padrão. Lançamento sempre vem com reação dividida. A VentureBeat registrou críticas duras de usuários avançados que testaram o GPT-6.2 antes do lançamento, mesmo com os recordes em benchmark. Isso não quer dizer que o modelo é ruim. Quer dizer que benchmark e experiência real não são a mesma coisa, e que uma semana de uso dos outros me poupa de várias horas de migração.
O que eu faria se estivesse começando hoje
Se você usa um único modelo para tudo, não precisa montar um orquestrador amanhã. Comece pelo simples: pegue as tarefas da última semana, separe nos quatro baldes acima e, por uma semana, use o modelo mais barato que você confia nos baldes 1 e 2. Anote quantas vezes precisou refazer. Em quase todo time que eu vi, a conta fecha a favor do roteamento, com folga.
E, principalmente, pare de tratar lançamento como evento. Quatro modelos em dez dias é o novo normal. Quem tem um processo para avaliar e rotear absorve cada lançamento em uma tarde. Quem escolhe por manchete vive migrando.
Perguntas frequentes
Qual é o melhor modelo de IA para programar agora?
Não existe um só. Para tarefa mecânica, o mais barato que acerta de primeira no seu código. Para planejamento e bug difícil, um modelo de topo como Fable 5.2 ou GPT-6.2 Astra. Os próprios fabricantes recomendam combinar modelos em vez de usar o mais caro para tudo.
Benchmark não serve para nada, então?
Serve para montar a lista de candidatos, não para decidir. Quase todo benchmark de anúncio é escolhido e rodado pelo próprio fornecedor. A decisão final vem de testar nas suas tarefas, com os seus testes.
Vale pagar o modo rápido?
Só quando a latência trava o seu trabalho, como numa sessão interativa longa. O modo rápido do Fable 5.2 custa o dobro (US$ 16/80). Para tarefa em segundo plano, eu prefiro o preço normal ou até o Batch, que sai pela metade na Anthropic e na OpenAI.
Prefere a versão rápida? Veja a Web Story com o roteamento em 12 telas.
Quer ver isso na prática? No Labs de IA eu mostro como monto esse roteamento entre modelos no dia a dia, com Claude Code, agentes e as automações que uso de verdade.