Neste artigo
- O que é um worktree, em uma frase
- Como o Claude Code usa worktree hoje
- A pegadinha que todo mundo encontra: o .env
- Meu fluxo real: três sessões numa manhã
- Quando a tarefa é grande demais: subagentes com worktree próprio
- Onde o paralelismo quebra (e não é culpa da ferramenta)
- Limpeza: o lixo que ninguém vê
- Quando eu não paralelizo
- Perguntas frequentes
- Worktree é a mesma coisa que clonar o repositório de novo?
- Preciso do Claude Code para usar worktree com agente?
- Posso rodar dois worktrees na mesma branch?
Durante muito tempo eu rodei agente de código do jeito mais ingênuo possível: um terminal, uma tarefa, eu olhando. Quando comecei a abrir duas ou três sessões do Claude Code ao mesmo tempo no mesmo repositório, o resultado foi previsível. Um agente rodava o formatter enquanto o outro estava no meio de um refactor, um git checkout trocava a branch debaixo do pé do segundo, e eu passava a tarde descobrindo qual alteração era de quem.
Paralelismo com agente de IA não é um problema de prompt. É um problema de isolamento, o mesmo que a gente resolve há anos com container, fila e transação. E a ferramenta certa para isso já estava no Git desde 2015: o git worktree.
Minha tese neste artigo é simples: se você roda mais de um agente no mesmo repositório sem worktree, você não está paralelizando, está criando conflito de merge em tempo real. Abaixo eu mostro como eu organizo isso hoje com o Claude Code, o que a documentação oficial garante, onde estão as pegadinhas e quando eu prefiro não paralelizar.
O que é um worktree, em uma frase
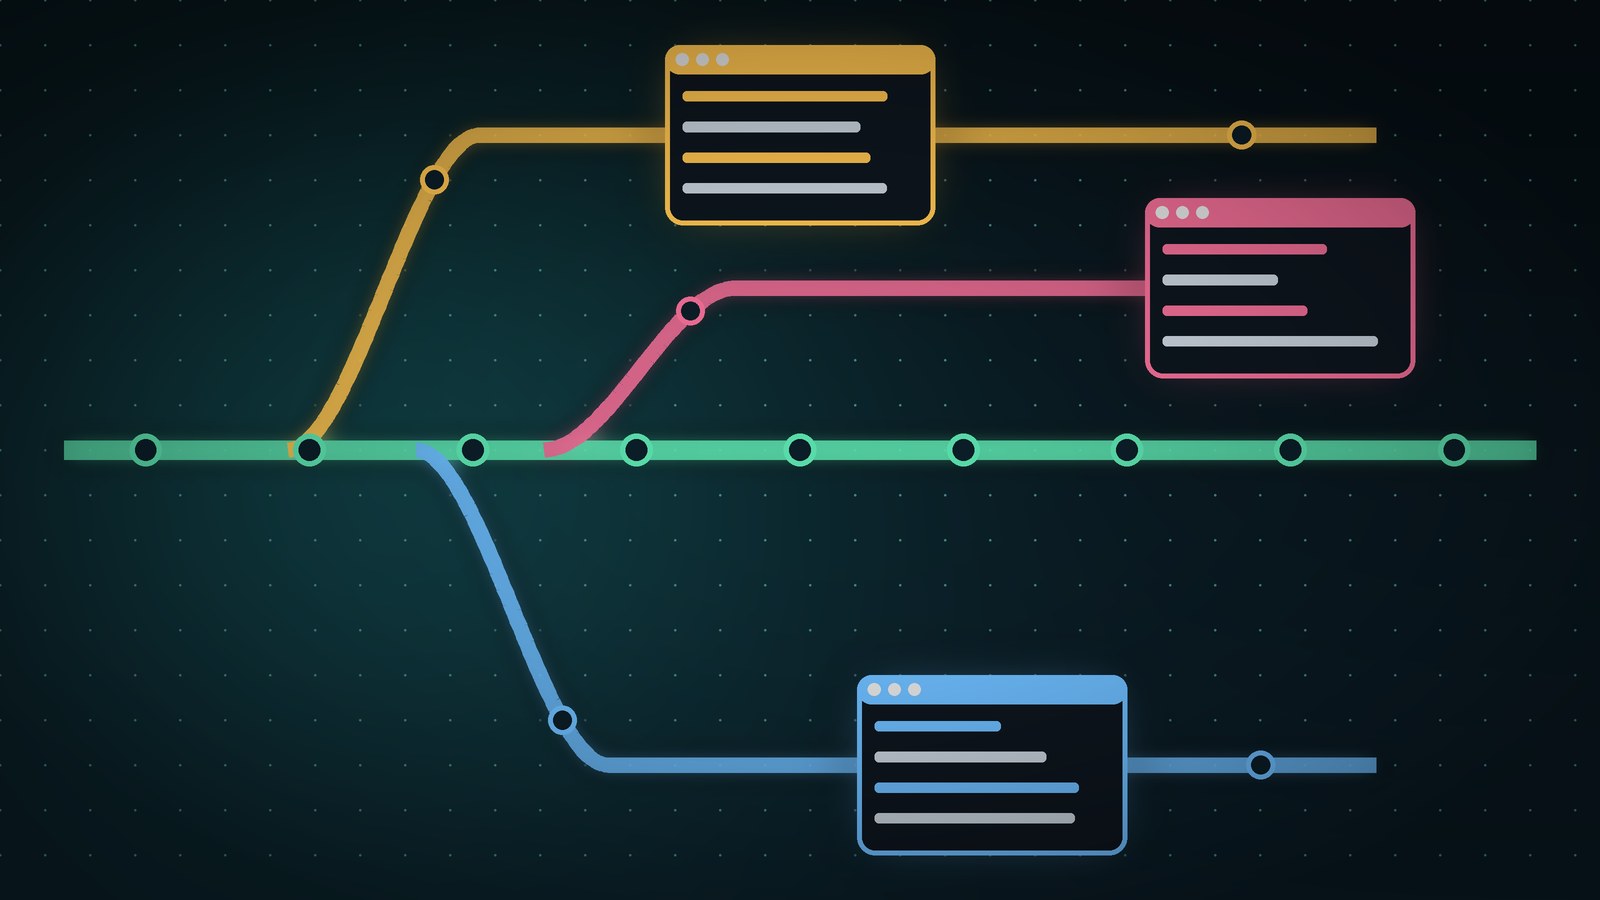
Um worktree do Git é um segundo diretório de trabalho ligado ao mesmo repositório: cada um tem seus próprios arquivos e sua própria branch, mas todos compartilham o mesmo histórico, o mesmo .git e o mesmo remote. Não é um clone. Você não baixa o repositório de novo, não duplica o histórico e um commit feito em um worktree já aparece para os outros.
Na prática, é como ter três mesas de trabalho no mesmo escritório, com o mesmo arquivo morto. Cada agente tem a sua mesa. Ninguém mexe no papel do outro.
Como o Claude Code usa worktree hoje
A boa notícia é que eu não preciso mais montar isso na mão. A documentação oficial do Claude Code sobre worktrees descreve uma flag própria para isso:
claude --worktree feature-auth
# ou, abreviado
claude -w fix-timeout-pix
Esse comando cria o worktree em .claude/worktrees/<nome>/, na raiz do repositório, numa branch nova chamada worktree-<nome>, e já abre a sessão lá dentro. Se eu rodo de novo em outro terminal com outro nome, ganho uma segunda sessão isolada. Se eu omito o nome, o Claude Code gera um aleatório.
Três detalhes da documentação que mudaram a forma como eu trabalho:
- Base limpa por padrão. O worktree nasce da branch padrão do remote (normalmente
main), não do que está sujo no meu checkout. Se eu quero que ele carregue meus commits locais, configuro"worktree": { "baseRef": "head" }no settings. - Dá para começar a partir de um PR.
claude --worktree "#1234"busca o head daquele pull request noorigine cria o worktree em.claude/worktrees/pr-1234. Para revisar PR de colega com ajuda do agente, isso é ouro. - Isolamento é verificado, não só sugerido. Dentro de um worktree, o Claude Code bloqueia edição de arquivo que aponte para o checkout principal, comando cujo diretório de trabalho seja o checkout principal e git redirecionado para lá via
git -C,GIT_DIRoucd.
Esse último ponto é o que me fez confiar no fluxo. Uma regra no CLAUDE.md dizendo “não mexa fora da sua pasta” é um pedido. Uma verificação na ferramenta é uma regra. É a mesma lógica que eu defendi no texto sobre hooks do Claude Code: o que importa de verdade tem que ser determinístico.
A pegadinha que todo mundo encontra: o .env
Worktree é um checkout novo. Arquivo ignorado pelo Git não vai junto. Então o primeiro agente sobe o projeto, não acha o .env, e você perde dez minutos achando que o bug é no código.
O Claude Code resolve isso com um arquivo .worktreeinclude na raiz, com a sintaxe do .gitignore. Só arquivos que casam com o padrão e estão ignorados pelo Git são copiados para cada worktree novo:
# .worktreeinclude
.env
.env.local
config/secrets.json
Aqui vai uma opinião que vem de quem já viu credencial vazar: use só segredo de desenvolvimento nesses arquivos. Cada worktree é mais uma cópia do segredo no disco, e agente tem o hábito de ler tudo o que está à mão. Se o seu .env local tem chave de produção, o problema não é o worktree, é o .env. Falei mais sobre isso quando o rastro do agente virou o novo .env.
Duas outras coisas que valem para o seu .gitignore e para o setup:
# .gitignore
.claude/worktrees/
E lembre que cada worktree precisa das dependências instaladas. Em projeto Node isso é um npm ci por worktree; em Python, um venv por worktree. Eu deixo isso explícito no prompt inicial em vez de esperar que o agente adivinhe.
Meu fluxo real: três sessões numa manhã
Um exemplo de como eu divido uma manhã num serviço de backend. Três tarefas independentes, três terminais:
# terminal 1: feature nova, a tarefa que eu acompanho de perto
claude -w endpoint-relatorio

# terminal 2: bug com teste que reproduz
claude -w fix-timeout-fila

# terminal 3: tarefa mecânica, roda sem eu olhar
claude -w migrar-logger
O prompt de abertura de cada sessão segue o mesmo esqueleto. Repare que ele define o que é “pronto” antes de definir o que fazer:
Você está num worktree isolado. Antes de qualquer edição:
1. Instale as dependências (npm ci) e rode a suíte de testes.
   Se algo já falhar, pare e me avise.
2. Tarefa: trocar o logger antigo pelo novo nos módulos de src/jobs/.
3. Pronto significa: testes verdes, lint limpo, nenhum arquivo
   fora de src/jobs/ alterado, um commit por módulo.
4. Não faça push. Ao terminar, liste os commits e o diff --stat.
O agente do terminal 3 trabalha sozinho. O do terminal 2 eu olho de vez em quando. O do terminal 1 eu acompanho turno a turno, porque é ali que estão as decisões de design. Paralelizar não significa dar a mesma atenção para tudo; significa gastar atenção só onde ela vale.
Quando a tarefa é grande demais: subagentes com worktree próprio
Para trabalho mecânico espalhado por muitos arquivos, eu prefiro deixar o próprio Claude Code dividir. A documentação mostra que um subagente customizado pode rodar sempre isolado em worktree com uma linha no frontmatter:
---
name: refactorer
description: Aplica refactors mecânicos em muitos arquivos
isolation: worktree
---

Aplique o refactor pedido em todos os arquivos afetados,
rode os testes e reporte o resultado.
Cada subagente ganha um worktree temporário, que é removido automaticamente se ele terminar sem alterações. Existe ainda o /batch, uma skill que, segundo a página oficial sobre agentes em paralelo, divide uma mudança grande em 5 a 30 subagentes isolados em worktree.
Uma ressalva importante da mesma documentação: agent teams não isolam os membros do time em worktrees. Se você usa esse modo (experimental e desligado por padrão), precisa dividir o trabalho para que cada agente seja dono de um conjunto diferente de arquivos. Eu prefiro worktree justamente por não depender dessa disciplina.
Onde o paralelismo quebra (e não é culpa da ferramenta)
Isolamento resolve o conflito durante o trabalho. Ele não resolve o conflito na hora de juntar. Os problemas que eu mais vejo:
- Tarefas que não são independentes. Dois agentes mexendo no mesmo módulo em worktrees diferentes só empurram o conflito para o merge. Antes de abrir o segundo terminal, eu me pergunto: essas duas tarefas tocam os mesmos arquivos? Se sim, elas são sequenciais.
- Recurso compartilhado fora do Git. Worktree isola arquivos, não isola banco local, porta e fila. Três agentes rodando teste de integração contra o mesmo Postgres local na mesma porta vão se atropelar. Eu resolvo com banco por worktree (nome do schema derivado do nome da branch) ou deixando só um agente rodar integração.
- O gargalo vira eu. Três agentes produzem três diffs. Se eu não consigo revisar três diffs com cuidado, eu só multipliquei o risco. É por isso que limito a quantidade de sessões ao que consigo revisar, e uso o método que descrevi em como eu reviso PR gerado por IA.
- Custo. A documentação avisa: rodar várias sessões ou subagentes ao mesmo tempo multiplica o uso de tokens. Paralelismo é para ganhar tempo de relógio, não para economizar.
Limpeza: o lixo que ninguém vê
Ao sair de uma sessão interativa num worktree, o Claude Code verifica se há trabalho que seria perdido. Se o worktree está limpo e a sessão não tem nome, ele remove o worktree e a branch sozinho. Se há alterações, ele pergunta se você quer manter ou remover. Já sessões não interativas com -p não têm esse prompt de saída, então os worktrees ficam para trás.
Por isso eu tenho o hábito de rodar, no fim do dia:
git worktree list
git worktree remove .claude/worktrees/migrar-logger
git worktree prune
Se o Git recusar porque o worktree está travado (o Claude Code mantém um git worktree lock enquanto o agente roda), é sinal de que ainda há sessão ativa ou um lock sobrando; a documentação orienta usar git worktree unlock antes de remover.
Quando eu não paralelizo
Para não parecer que worktree é bala de prata, as situações em que eu continuo com um agente só:
- Tarefa exploratória, em que eu ainda não sei o que quero. Paralelizar dúvida gera três respostas erradas diferentes.
- Bug de produção urgente. Foco total, um terminal, eu no controle.
- Mudança de arquitetura que atravessa o projeto inteiro. Aqui eu quero um plano revisado antes de qualquer código, e depois quebro em PRs pequenos e revisáveis.
O ganho real do paralelismo aparece quando eu tenho um backlog de tarefas pequenas, independentes e com critério de pronto claro. É aí que três worktrees viram três entregas na mesma manhã.
Perguntas frequentes
Worktree é a mesma coisa que clonar o repositório de novo?
Não. O clone duplica o histórico inteiro. O worktree compartilha o mesmo .git e o mesmo remote; só os arquivos de trabalho e a branch são separados. Um commit feito num worktree já fica visível nos outros.
Preciso do Claude Code para usar worktree com agente?
Não. Dá para criar com git worktree add ../projeto-feature -b feature e abrir qualquer agente dentro da pasta. A vantagem da flag --worktree é automatizar a criação, a cópia dos arquivos ignorados e a limpeza, além das verificações de isolamento.
Posso rodar dois worktrees na mesma branch?
O Git não deixa a mesma branch ficar em checkout em dois worktrees ao mesmo tempo, salvo se você forçar. E é bom que não deixe: é exatamente o tipo de conflito que você queria evitar.
Prefere a versão rápida? Veja a Web Story com o fluxo em 11 telas.
Quer ver isso rodando? No Labs de IA eu mostro na prática como organizo agentes, worktrees e automações com Claude Code no meu dia a dia de dev.